AI 功能到底怎么验收:一套从业务风险里长出来的测试集
「这个版本好像回答得更自然了」——没有测试集的 AI 产品,验收只能停在感觉层面。一个智能购车问答项目从零搭建测试集的全过程,和它带来的启发。
AI 功能到底怎么验收?
传统功能的验收路径很清晰:流程是否跑通、接口是否返回正确结果。但 AI 问答完全不同——同一个问题,模型每次的措辞都可能不一样,答案看起来似乎都没什么毛病。今天测试体验不错,不代表明天换了参数还能稳定。
讲 Agent 架构的文章很多,讲 Prompt 技巧的也很多,但认真讲「验收」的很少。有一个智能购车问答团队从零搭建测试集的过程,值得拆开看——它几乎把这件事的关键决策点都踩了一遍。
没有测试集的三个症状
没有测试集的团队,状态通常很一致,三个症状:
- 验收靠感觉——「这个版本好像回答得更自然了」,但说不清好在哪里;
- Prompt 优化变成玄学——改一句提示词、试几条 case 就上线;
- Bad Case 反复出现——这次修掉了,下个版本又复现,因为没有回归机制。
这种状态下的 AI 产品,本质上是在靠运气运行。
为什么购车问答需要单独的评测体系
购车问答和普通闲聊最大的区别是:它会直接影响用户决策。 有两个很能说明问题的案例。
第一个案例:用户问「这款车适合三口之家吗」,模型回答「适合,空间大、续航长」。看起来没毛病对吧?但产品 review 时判定这个答案不合格——真正有帮助的回答应该结合空间数据、安全配置、用车场景和预算来展开,而不是笼统一句「空间大」。
第二个案例更严重:模型在回答优惠问题时,自行编造了一条「本月购车赠送充电桩」的权益,运营团队发现后紧急下线。这件事之后团队才真正意识到:在高决策成本场景里,AI 问答的质量不能只看顺不顺,还要看参数是否准确、信息是否完整、是否抑制了幻觉和过度承诺。
测试集的意义,就是把「好答案」的标准从主观判断变成可复用、可评测的样本集合。
设计思路:覆盖决策链路,而不是堆数量
很多团队一开始做测试集,容易把它当成「收集一百条问题」的任务。常见的翻车方式是这样的:第一批只有五十条问题,全是「XX 车型续航多少」这类简单问答。结果 Prompt 一改,简单问题都答得很好,但用户实际常问的「家用选哪款」「和竞品比怎么样」全部翻车。
真正可用的测试集,是对用户决策链路的覆盖,至少包括七类:
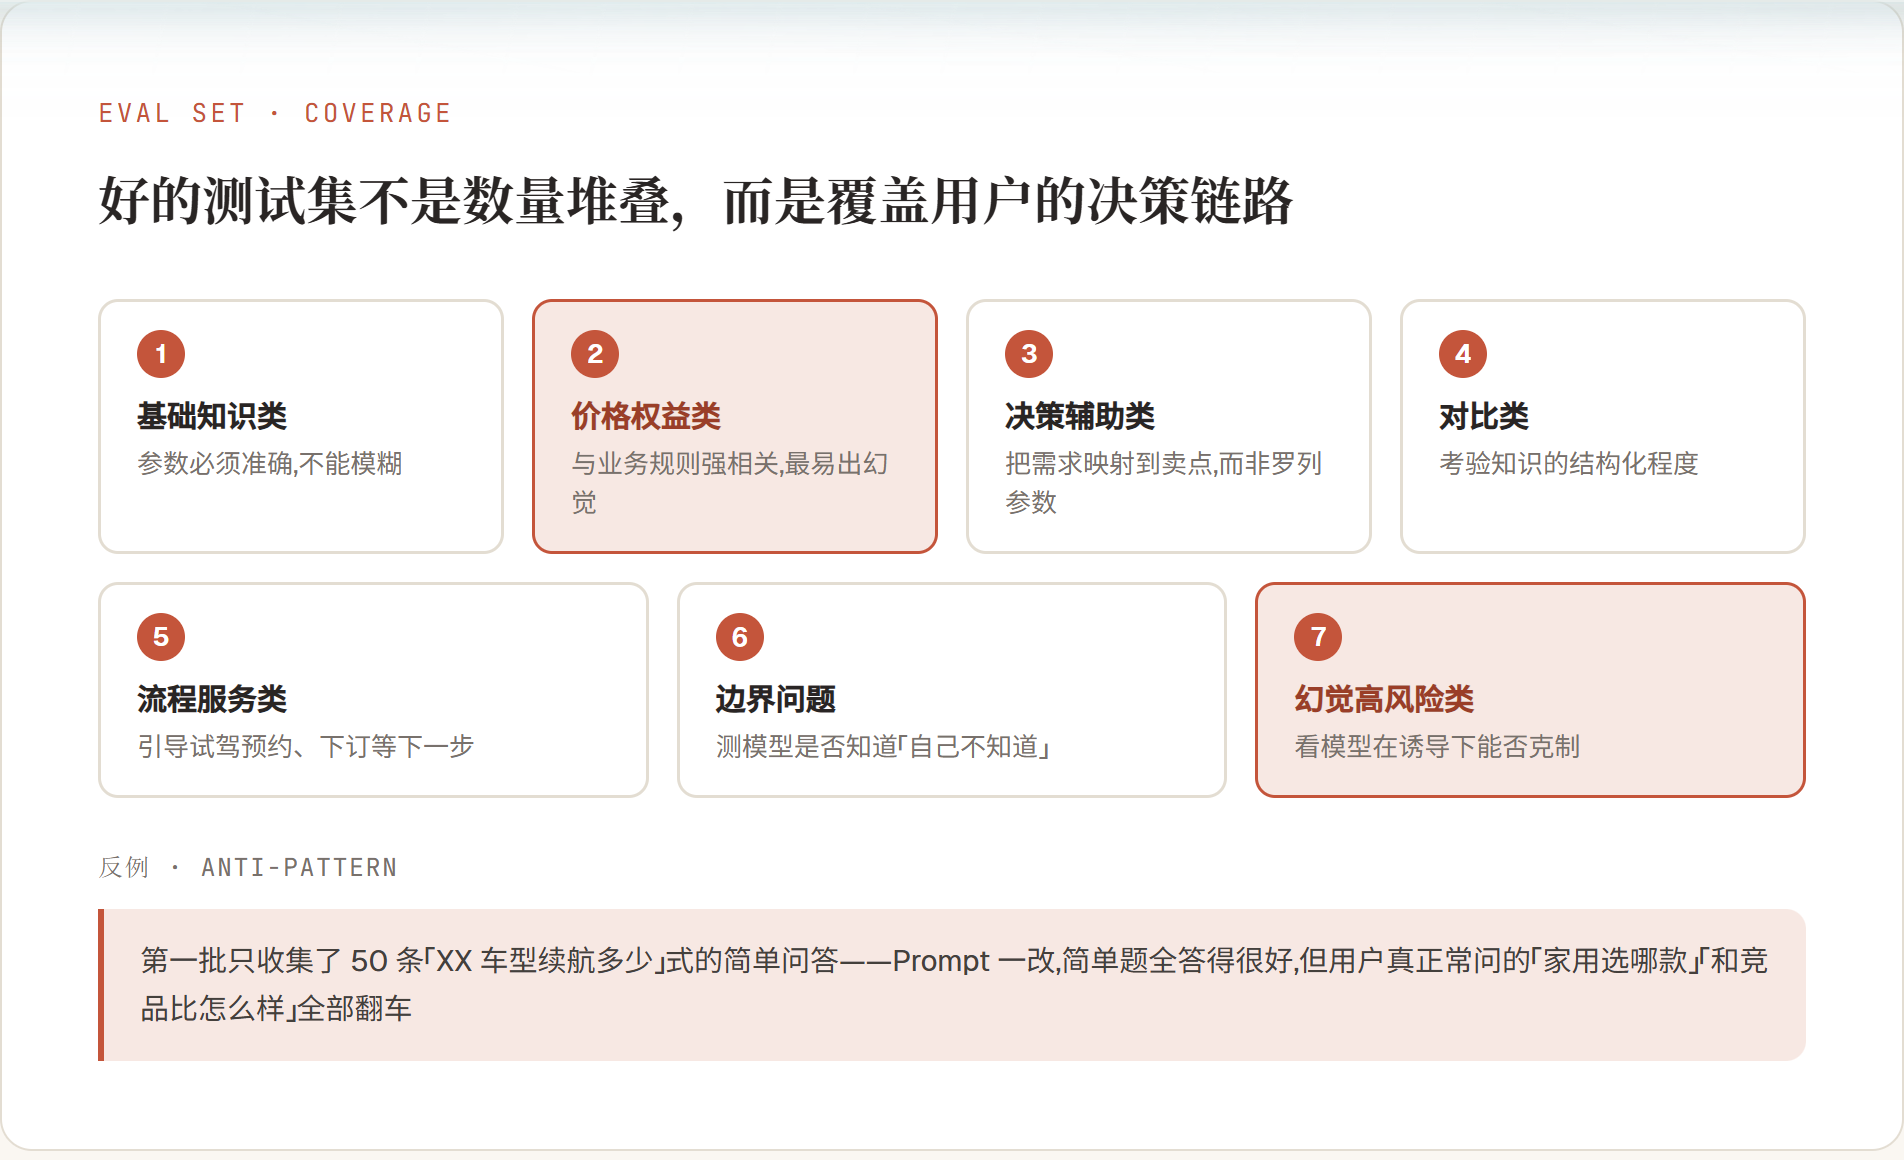
fig. 价格权益和幻觉高风险两类,是最容易被忽略也最容易出事的
每条测试样本也要结构化:用户问题、场景分类、期望要点、知识来源、是否需要检索、是否允许归纳、幻觉风险、评分维度。这个设计的价值在于可归因——当模型答错时,能判断到底是知识库缺失、检索未命中、模型没用检索结果,还是 Prompt 约束不足。没有这个结构,改错就是盲人摸象。
五类指标,和一次团队摩擦
指标设计本身也是不断对齐的过程。一开始只看准确性,很快发现不对:
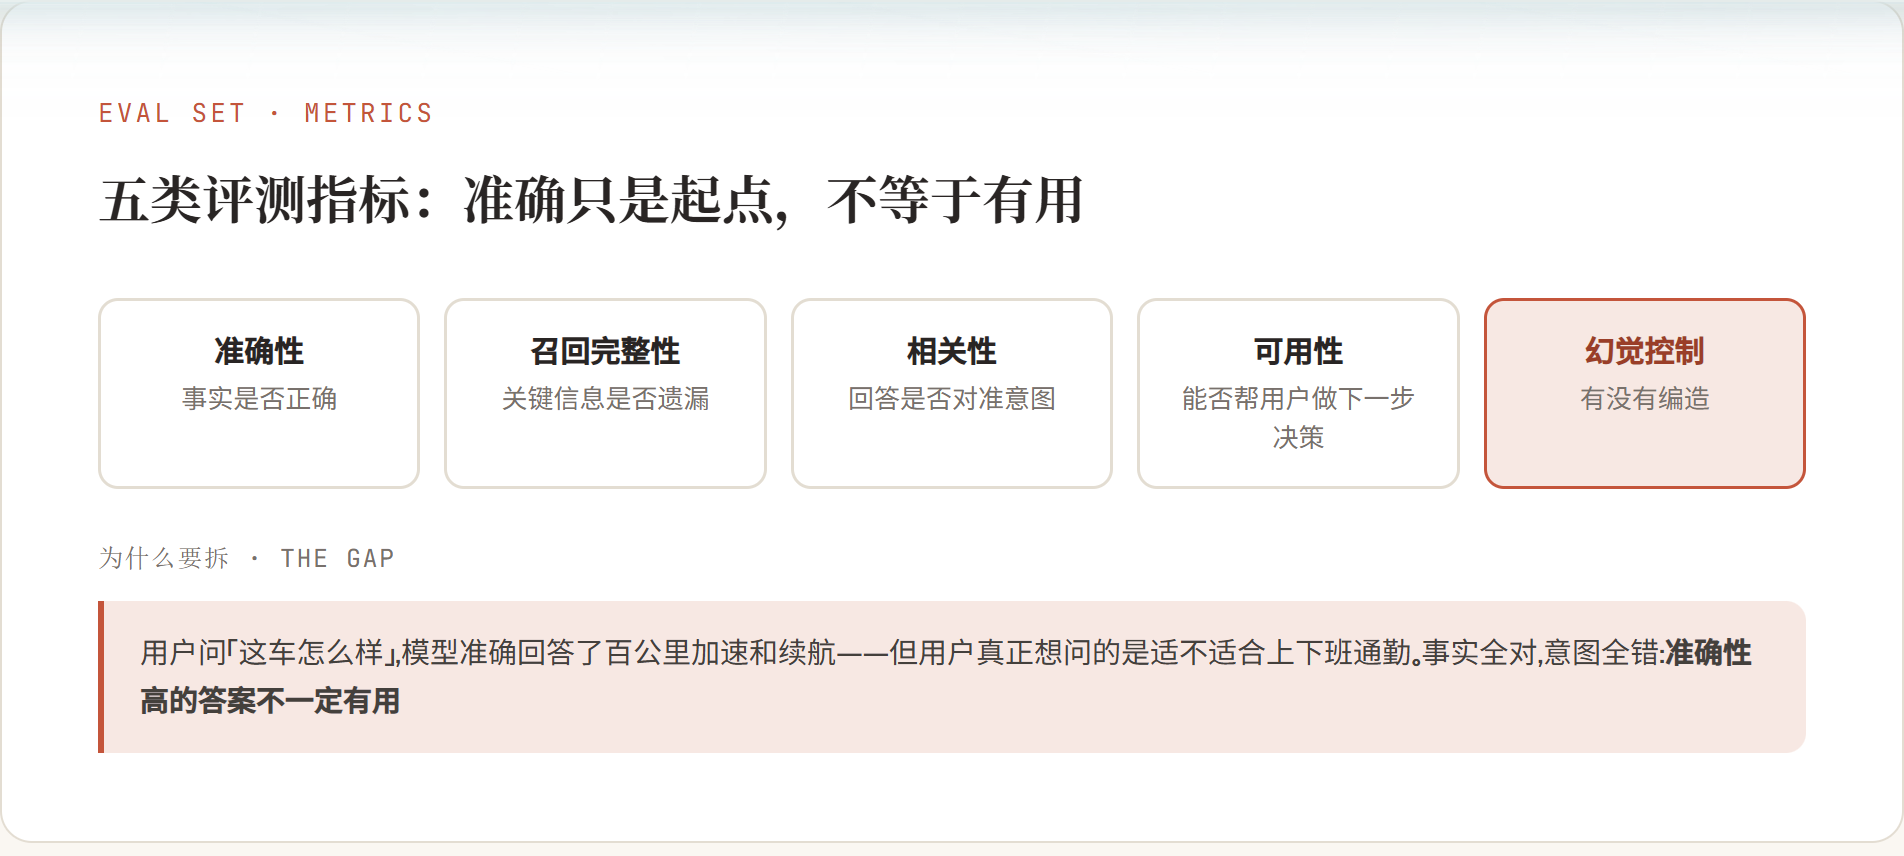
fig. 事实全对、意图全错的答案,在准确性指标下是满分
于是拆成五类:准确性看事实是否正确、召回完整性看关键信息是否遗漏、相关性看回答是否对准意图、可用性看能否帮用户做下一步决策、幻觉控制看有没有编造。
这部分有个很真实的组织细节:五个指标刚推出来时,研发团队不理解——「产品经理为什么管评测,这不是算法的事吗?」直到一次回归测试发现模型编造了一条不存在的置换补贴。如果上线,涉及虚假宣传的法律风险,公司担不起。从那之后,研发团队主动要求每次 Prompt 变更必须跑完完整测试集。 测试集就这样成了业务风控的一环。
贯穿全链路,和「准确」两个字的教训
测试集不是验收前才拿出来用的东西,它贯穿模型选型、Prompt 优化、知识库建设和版本回归的每个环节。
模型选型时的对比很有意思:模型 A 在通用对话评测上分数更高,差点直接选 A;但用业务测试集一跑,发现 A 在价格权益类问题上的幻觉率高出 B 将近一倍,最终选了 B。——通用排行榜和业务表现,可能是两回事。
Prompt 优化的教训更微妙,值得单独记住:
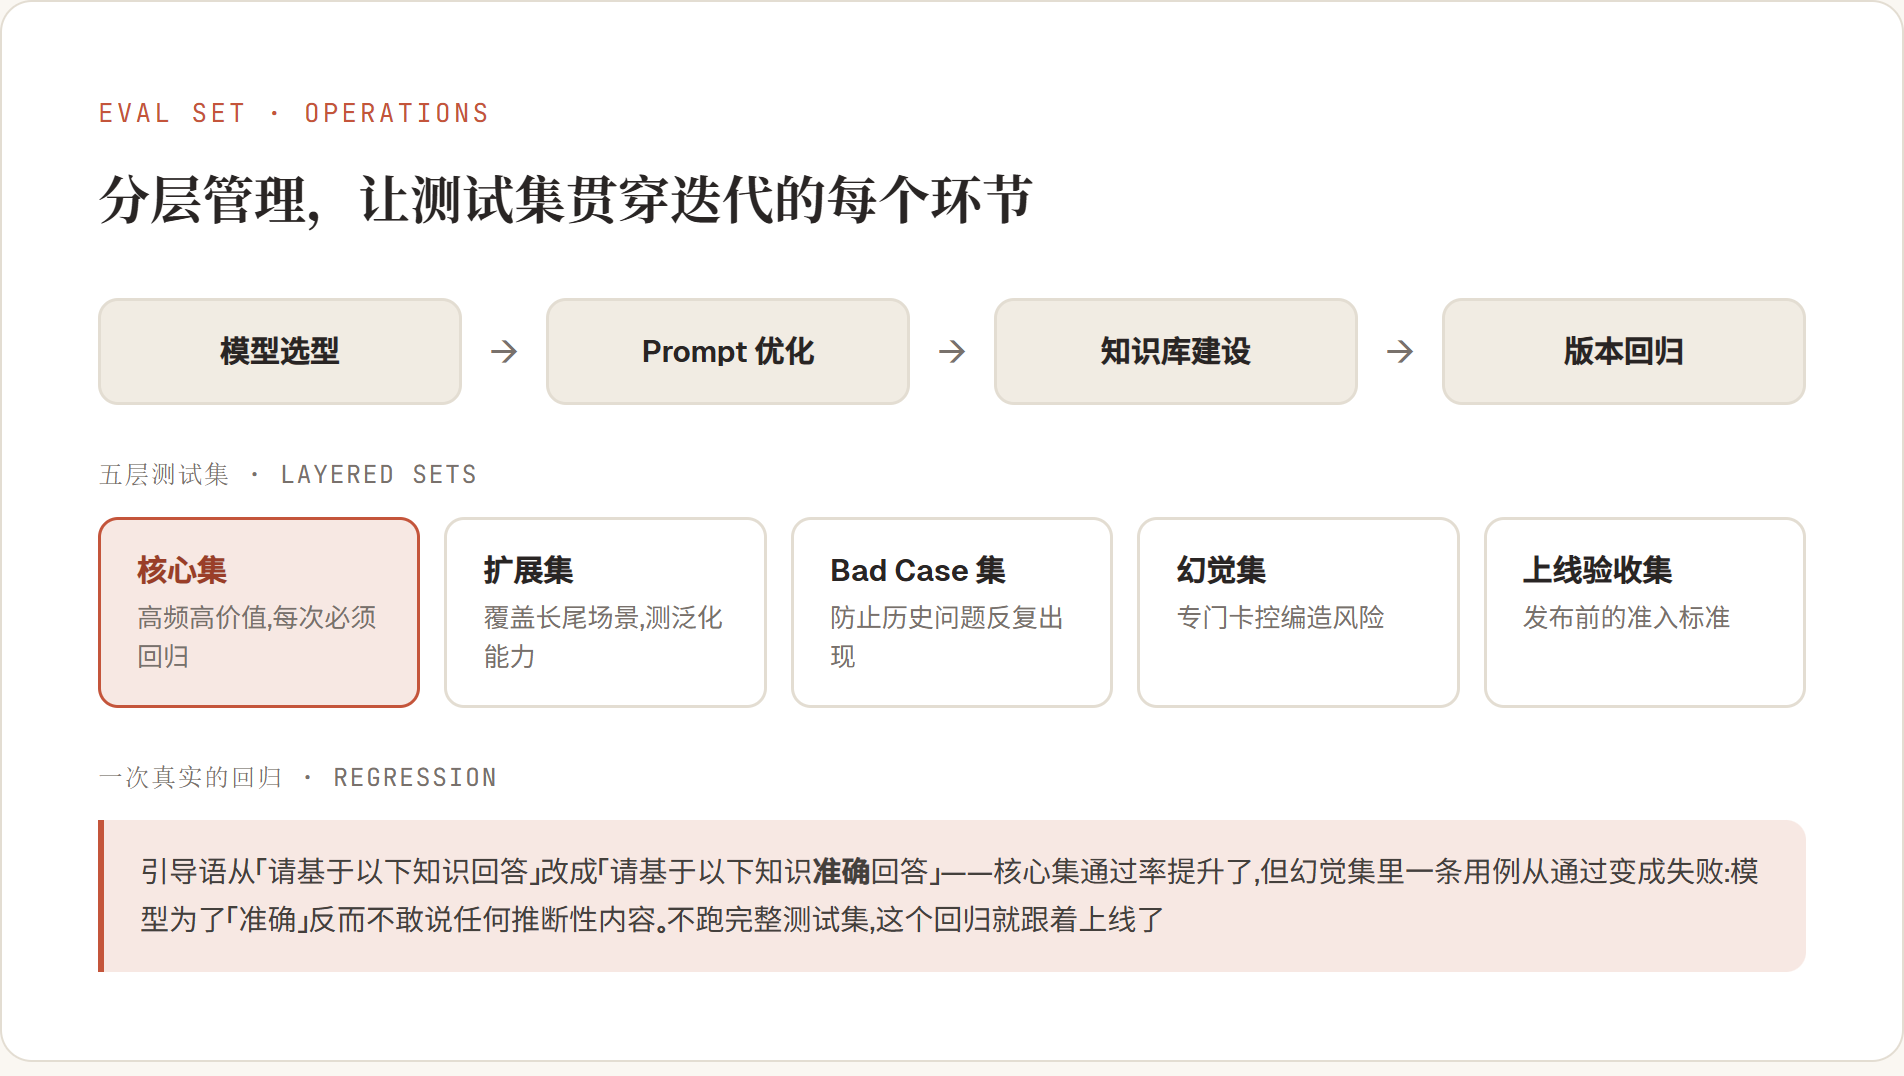
fig. 一次 Prompt 微调引发的真实回归
样本多了之后需要分层管理:核心集高频高价值、每次必须回归;扩展集覆盖长尾场景、测泛化能力;Bad Case 集防止历史问题反复;幻觉集专门卡控编造风险;上线验收集作为发布前的准入标准。
我的几点看法
测试集是 PM 手里「定义权」的来源。 没有评测体系的时候,你说这个版本变好了,研发说那个版本也不错,争论半天谁也说不动谁;有了测试集,每次改动是好是坏跑一遍就知道。而当产品经理开始用测试集和指标来定义上线标准,他在团队里的角色就从「提需求的」变成了「定标准的」。这是测试集最被低估的价值——它不是 QA 工具,是产品经理在 AI 团队里的立身之本。
「通用」在深水区都不好使。 模型选型那段让我想起 B 端落地里的一个现象:客户主动拒绝大厂通用方案,理由是「太通用」。这里的版本是:通用评测分数更高的模型,在你的业务场景里幻觉率反而翻倍。两条线索指向同一个结论——越靠近真实业务,越需要自己的尺子。测试集就是那把尺。
评测体系本质是组织信任的基础设施。 上面那些转折点都不是技术时刻,而是信任时刻:研发从「PM 为什么管评测」到「每次变更必须跑测试集」,靠的不是说服,是一次几乎上线的法律风险。说得更直白一点:先搞清楚什么样的回答算好,再弄一批标准问题反复考模型,改一次测一次——别等用户骂了再找原因。
结尾
测试集不是一次性文档,也不是技术团队的专属工具,而是 AI 产品长期运营的基础设施,更是 AI 产品经理走向工程化的第一步。
从「感觉判断」到「数据说话」,中间隔着的不是某个模型或某个工具,而是一套你自己定义的、可以被反复执行的验收标准。AI 产品的确定性,不来自模型承诺了什么,来自你能验证什么。