把 Coding Agent 从单兵作战变成工程团队:一套多智能体协作规范
Coding Agent 的问题已经不是「能不能干活」,而是「能不能不迷路、不污染上下文、交付可验证的结果」。一套多智能体流水线的设计逻辑,和它带来的启发。
Coding Agent 到了今天这个阶段,问题已经变了。
能不能写代码不再是问题——Claude Code、Codex 们早就证明了这一点。真正的问题变成了:怎么让 Agent 在复杂任务里不迷路、不污染上下文、不反复犯错,并且交付可验证的结果。
一个很有参考价值的解法是:别指望一个 Agent 包打天下,给它配一个「工程团队」。这套多智能体协作规范的设计相当完整,值得拆开看。
问题:单 Agent 的五种失控
先把问题说清楚。单个 Coding Agent 在复杂任务面前,会稳定地出现五种失控:
- 上下文越来越脏——调查日志、报错堆栈、中间过程全堆在一个会话里,越到后面越糊涂;
- 角色混在一起——写代码的是自己,检查代码的还是自己,自己证明自己正确;
- 长任务后期质量下降——开头精神抖擞,写到后面开始敷衍;
- 失败后缺少责任边界——错了不知道谁错了,该谁修、该谁验都不清楚;
- 最终结果缺少证据——一句「我已经完成了」,没有测试输出,没有验证记录。
把这五条连起来看,答案其实很明显:一个真实工程团队解决这些问题靠的不是更聪明的程序员,而是分工和流程——有人规划、有人实现、有人测试、有人审查,最后有人汇总证据。那为什么不把这个结构搬给 Agent?
解法:不写死角色,写「生成规范」
方案的核心设计是:不预设 planner / developer / tester 这种固定角色清单,而是建立一套动态子智能体生成规范。
主智能体只做一件事:当 coordinator。它判断任务是否真的需要多智能体、拆分边界、为每个子任务生成一份完整的 brief、分发、收集结果文件、判断通过还是失败、最后汇总证据交付报告。
子智能体按需生成,大致六种:
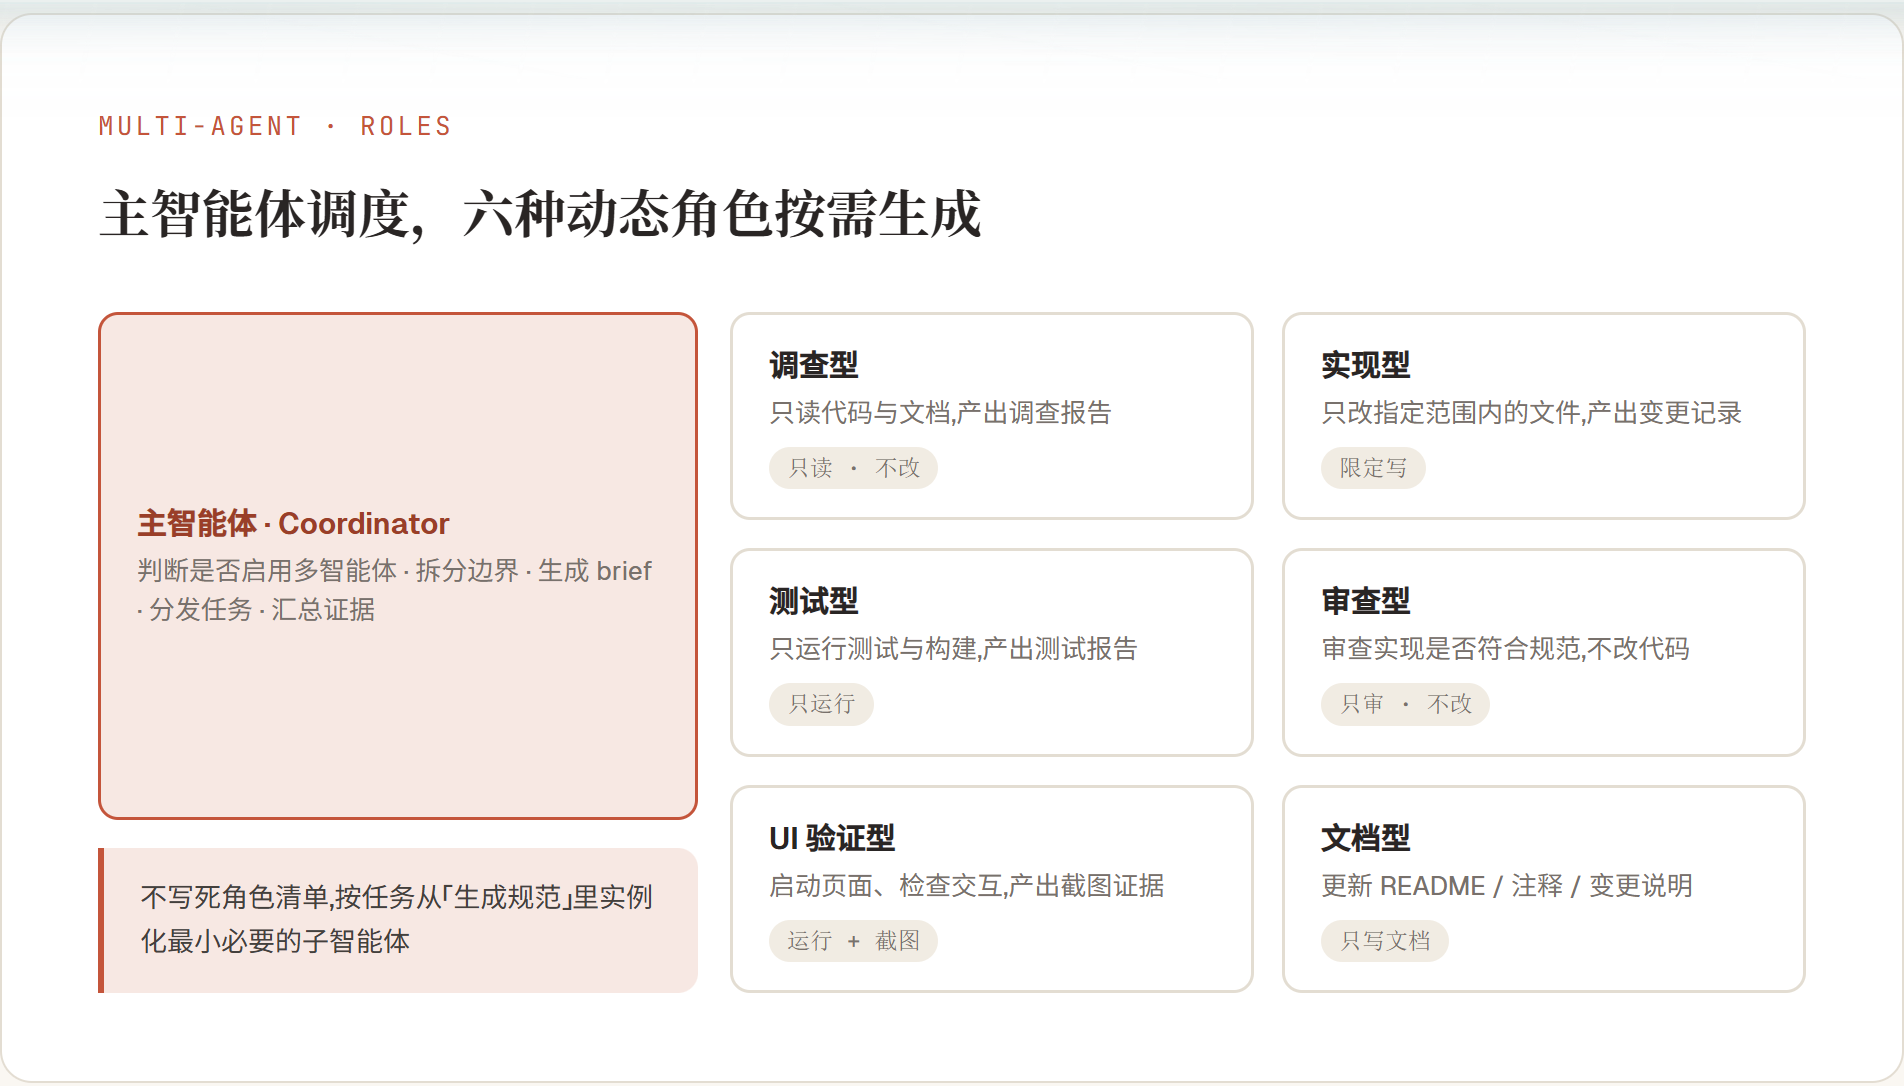
fig. 每个角色都有明确的权限边界:能看什么、能改什么、产出到哪
注意每个角色标签里的权限——「只读不改」「限定写」「只运行」。这不是装饰,是整套系统能跑起来的关键:权限边界越清晰,Agent 越不容易越界添乱。
启用时机也有明确标准:多文件功能开发、复杂 bug 调查、重构、前端实现+验证、测试补齐、性能安全审查——适合;简单问答、单文件小改动——别折腾。有一条标准说得很到位:「能在一个上下文里清楚完成,就不要启用多智能体。」
一条受控流水线
整个流程跑起来是这样:
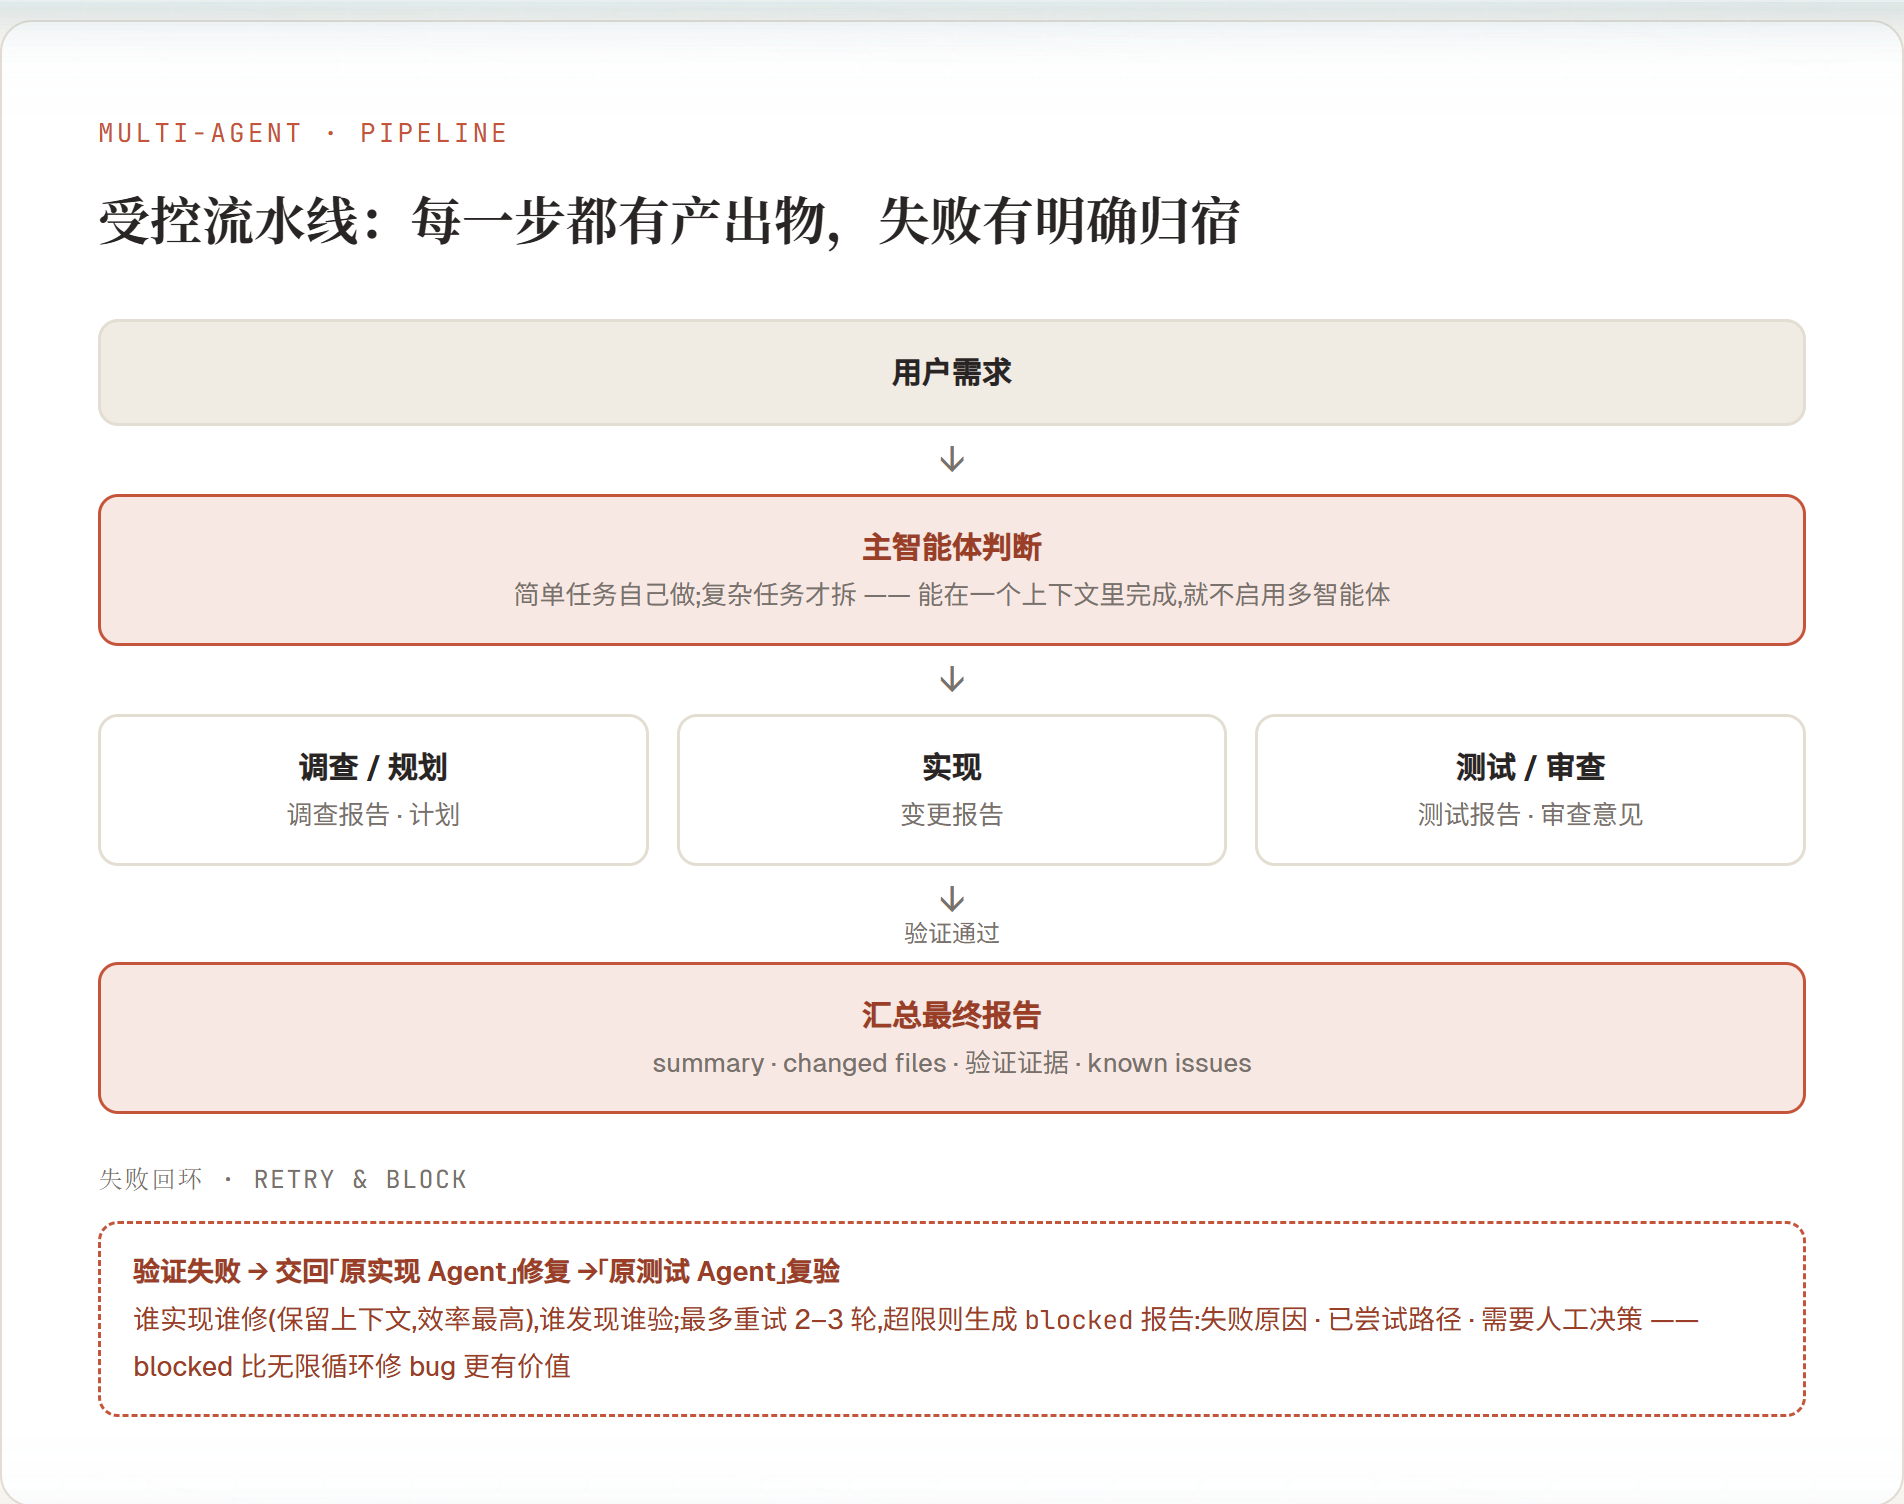
fig. 每一步都有产出物文件,失败有明确的回环和上限
这里有一个我认为最重要的设计决策:子智能体不直接决定下一步召唤谁,只返回状态和结果地址。
为什么重要?因为如果允许子智能体自己召唤子智能体,调度权就分散了——「Agent 继续召唤 Agent」,链条会失控,出问题时根本追不到责任链。所有调度决策收归 coordinator,是这套系统「可控」的根本原因。
两个关键细节
brief 模板,11 个字段。 主智能体不能随便甩一句「你去测试一下」,必须生成完整 brief:角色名、唯一目标、何时启用、输入文件、允许编辑范围、禁止动作、工具策略、输出路径、可验证的成功标准、停止条件、交接格式。比如一个实现型 Agent 的 brief 会写明:只允许改 src/routes/auth.ts 和 auth-service.ts,禁止改测试、禁止动 schema、禁止删接口、禁止 git commit。
文件交接协议。 完整结果全部写入文件(统一放在 .agent-runs/日期/任务号/ 目录),主会话只接收简短状态和文件路径:
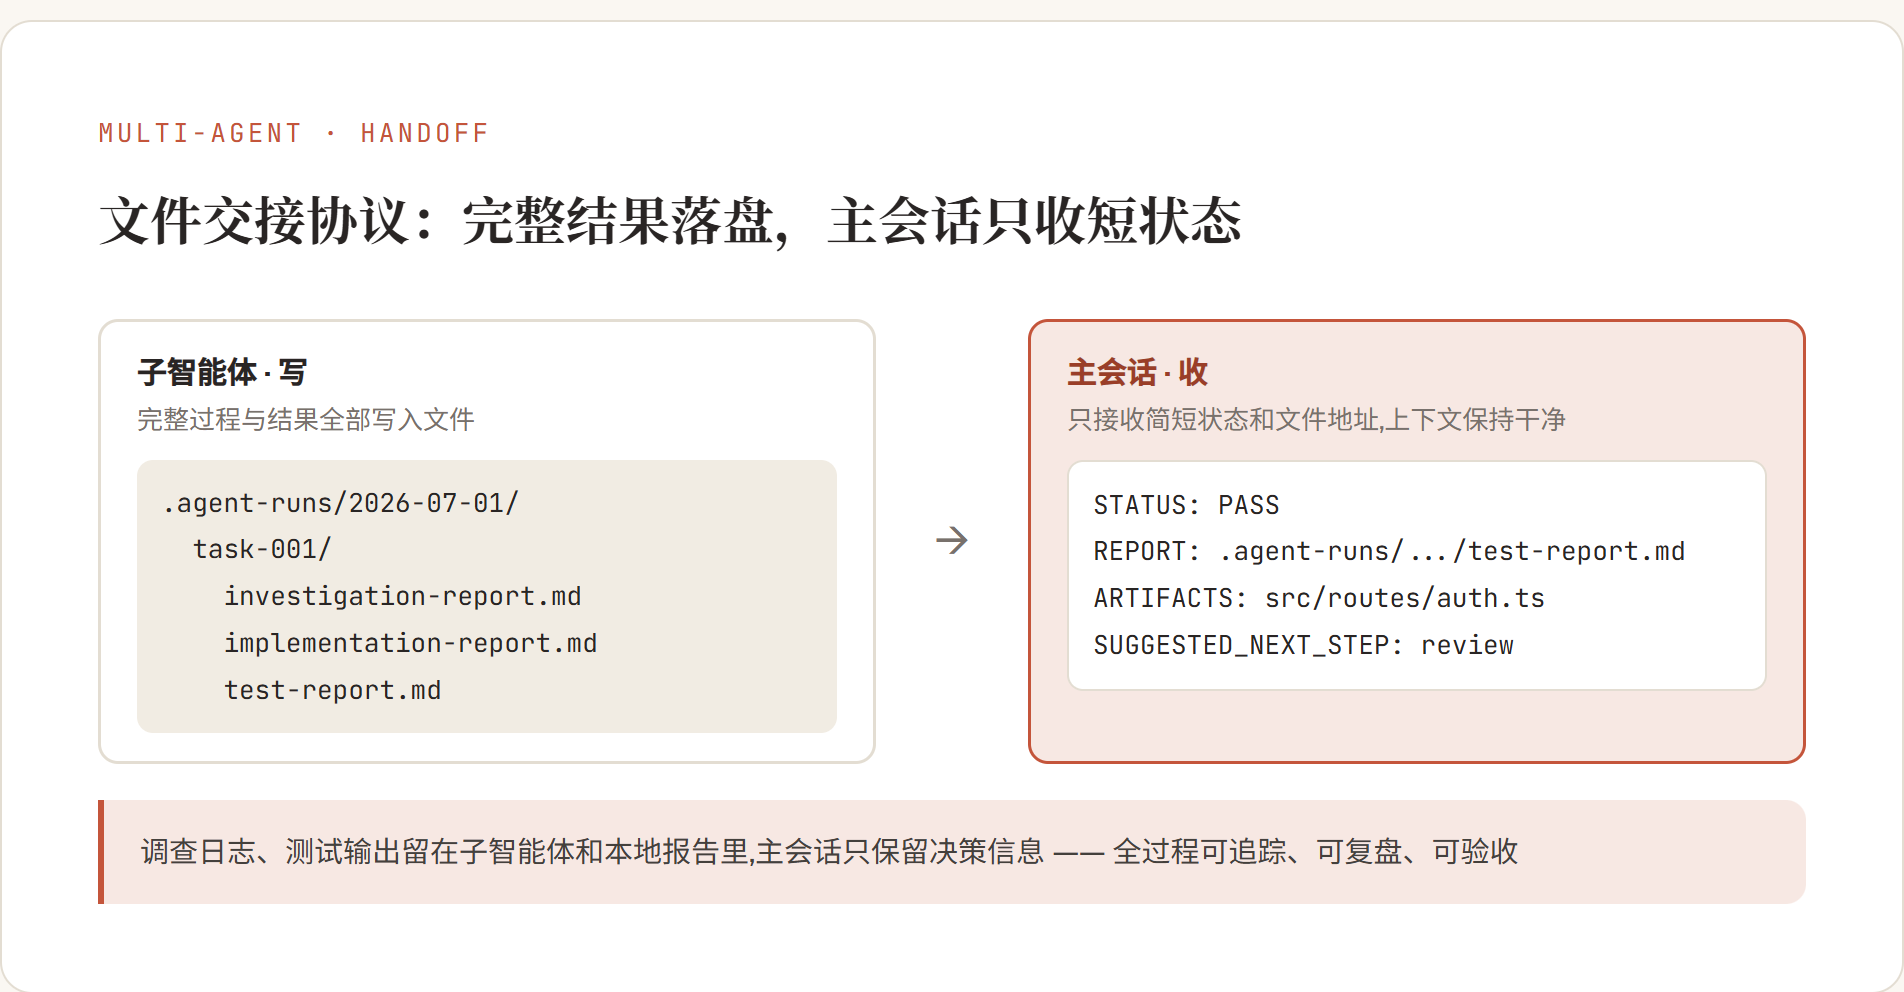
fig. 上下文保持干净的代价,是把纪律写进协议
这一条直接回应了「上下文越来越脏」的问题:调查日志、测试输出这些过程信息留在子智能体和本地报告里,主会话只保留决策信息。附带的好处是全过程可追踪——.agent-runs 目录就是一份自动生成的项目档案,可以复盘、可以验收、还能反过来优化规范本身。
失败怎么办:blocked 比无限循环有价值
失败修复机制设计得很克制:谁实现谁优先修,谁发现谁复验——实现 Agent 手里有开发上下文,修起来效率最高;测试失败就把失败报告交回原实现 Agent,修好再送回原测试 Agent 复验。
重试上限 2–3 轮,超限就停下来生成一份 blocked 报告:失败原因、已尝试的路径、涉及文件、疑似根因、需要人工做什么决策。
我很喜欢这个设计背后的判断:一份好的 blocked 报告比 Agent 无限循环修 bug 有价值得多。 它把「失败」从一种尴尬的状态变成了一种可交付的产出物——人也一样,一个能说清楚「我卡在哪、试过什么、需要什么决策」的协作者,远比一个闷头死磕的协作者可靠。
跑起来的样子
看一个完整的例子。用户输入一句话:「帮我给这个项目增加登录接口,包括参数校验、错误返回、测试,并确认不会影响现有注册接口。」
主智能体判断这是多文件功能开发,拆出五个子智能体:
auth-codebase-investigator:调查现有 auth 结构和错误处理方式,只读不改;auth-api-implementer:根据调查报告实现登录接口,只许改 routes 和 service;auth-api-test-writer:补充登录接口测试,只许改tests/auth.test.ts;auth-regression-verifier:运行 auth 相关测试,确认注册接口没被破坏;code-reviewer:审查实现是否符合项目规范,不改代码。
每个 Agent 输出报告文件,主智能体最后汇总:FINAL STATUS: PASS,附上 changed files 清单、测试与 typecheck 结果、四份报告的路径,以及一条 known issue——「未加 rate limit,建议单独开一个安全任务」。
对比一下普通 Agent 那句「我已经完成登录接口了」——这就是「说完成」和「证明完成」的区别。
这套方案真正提升的是什么
提升的不是单次代码生成能力,而是复杂任务的工程可控性。具体是五件事——降低上下文污染(过程信息留在子智能体里)、提高验证可信度(实现和测试分离,避免自己宣布自己成功)、让失败可追踪(每次失败有报告、原因、尝试路径)、让经验可沉淀(报告目录反过来优化规范)、最终让 Coding Agent 更像工程团队(调度归调度,执行归执行,把关归把关)。
边界也要说清楚:多智能体不是银弹,额外的 token 成本和流程复杂度是真实存在的,简单任务单 Agent 反而更快。而且不同工具的支持方式不同——Codex 更适合在明确要求时使用 subagent workflows,Claude Code 则可以通过自定义 subagents、skills、权限限制和 hooks 搭出更细的任务型工作流。
所以这套方案的最佳定位不是「重新发明 Agent 平台」,一个克制的定义是:给顶尖 Coding Agent 加上一套可复用的工程协作规范。 主智能体仍然是 Claude Code 或 Codex,做的事情只是给它们一套更清晰的组织方式——什么时候拆任务、拆给谁、允许改哪里、禁止做什么、如何交接、怎么验证、失败怎么修、最后怎么交付证据。
我的几点看法
这本质上是一份「组织设计文档」。 这套方案里没有一项技术是新的——角色分工、权限边界、交接协议、重试上限、blocked 升级机制,全都是软件工程管理里存在了几十年的实践。真正的创新在于把这些实践「编译」成了 Agent 能读取、能执行的规范文件。这提示了一个判断 Agent 方案的视角:当模型能力趋同,竞争点会转移到「工程纪律能否被形式化」。 人类团队靠文化和默契维持的东西,Agent 团队必须写成明文。
「什么时候不用」比「怎么用」更见功力。 整套方案里我最欣赏的不是流水线本身,而是那条启用标准——能在一个上下文里完成,就不要启用多智能体。技术方案的可信度,往往体现在它对自身边界的诚实程度上。这和 B 端落地里「劝客户别花冤枉钱」是同一个品质:克制。
对 PM 的启发:产品设计的对象正在从「界面」变成「协议」。 这套规范里的每个文件——when-to-use、role-schema、handoff-contract、retry-policy——本质上都是产品文档,只不过读者从工程师变成了 Agent。定义清楚「什么叫完成」「失败算谁的」「什么时候该停下来找人」,这些过去是管理问题,现在越来越多地是设计问题。PM 的技能树里,「为 Agent 写协作规范」正在变成一个真实的新分支。
结尾
当规范稳定下来之后,Coding Agent 就不再只是一个「会写代码的助手」,而更像一个有流程、有边界、有验收的小型工程团队。
单兵作战能力决定了 Agent 能走多快,而协作规范决定它能走多远。前者靠模型厂商,后者——恰恰是每个使用者自己手里能抓住的东西。